6 nov. 2026 · 20 min
IA générative : comment le calcul devient réponse ?
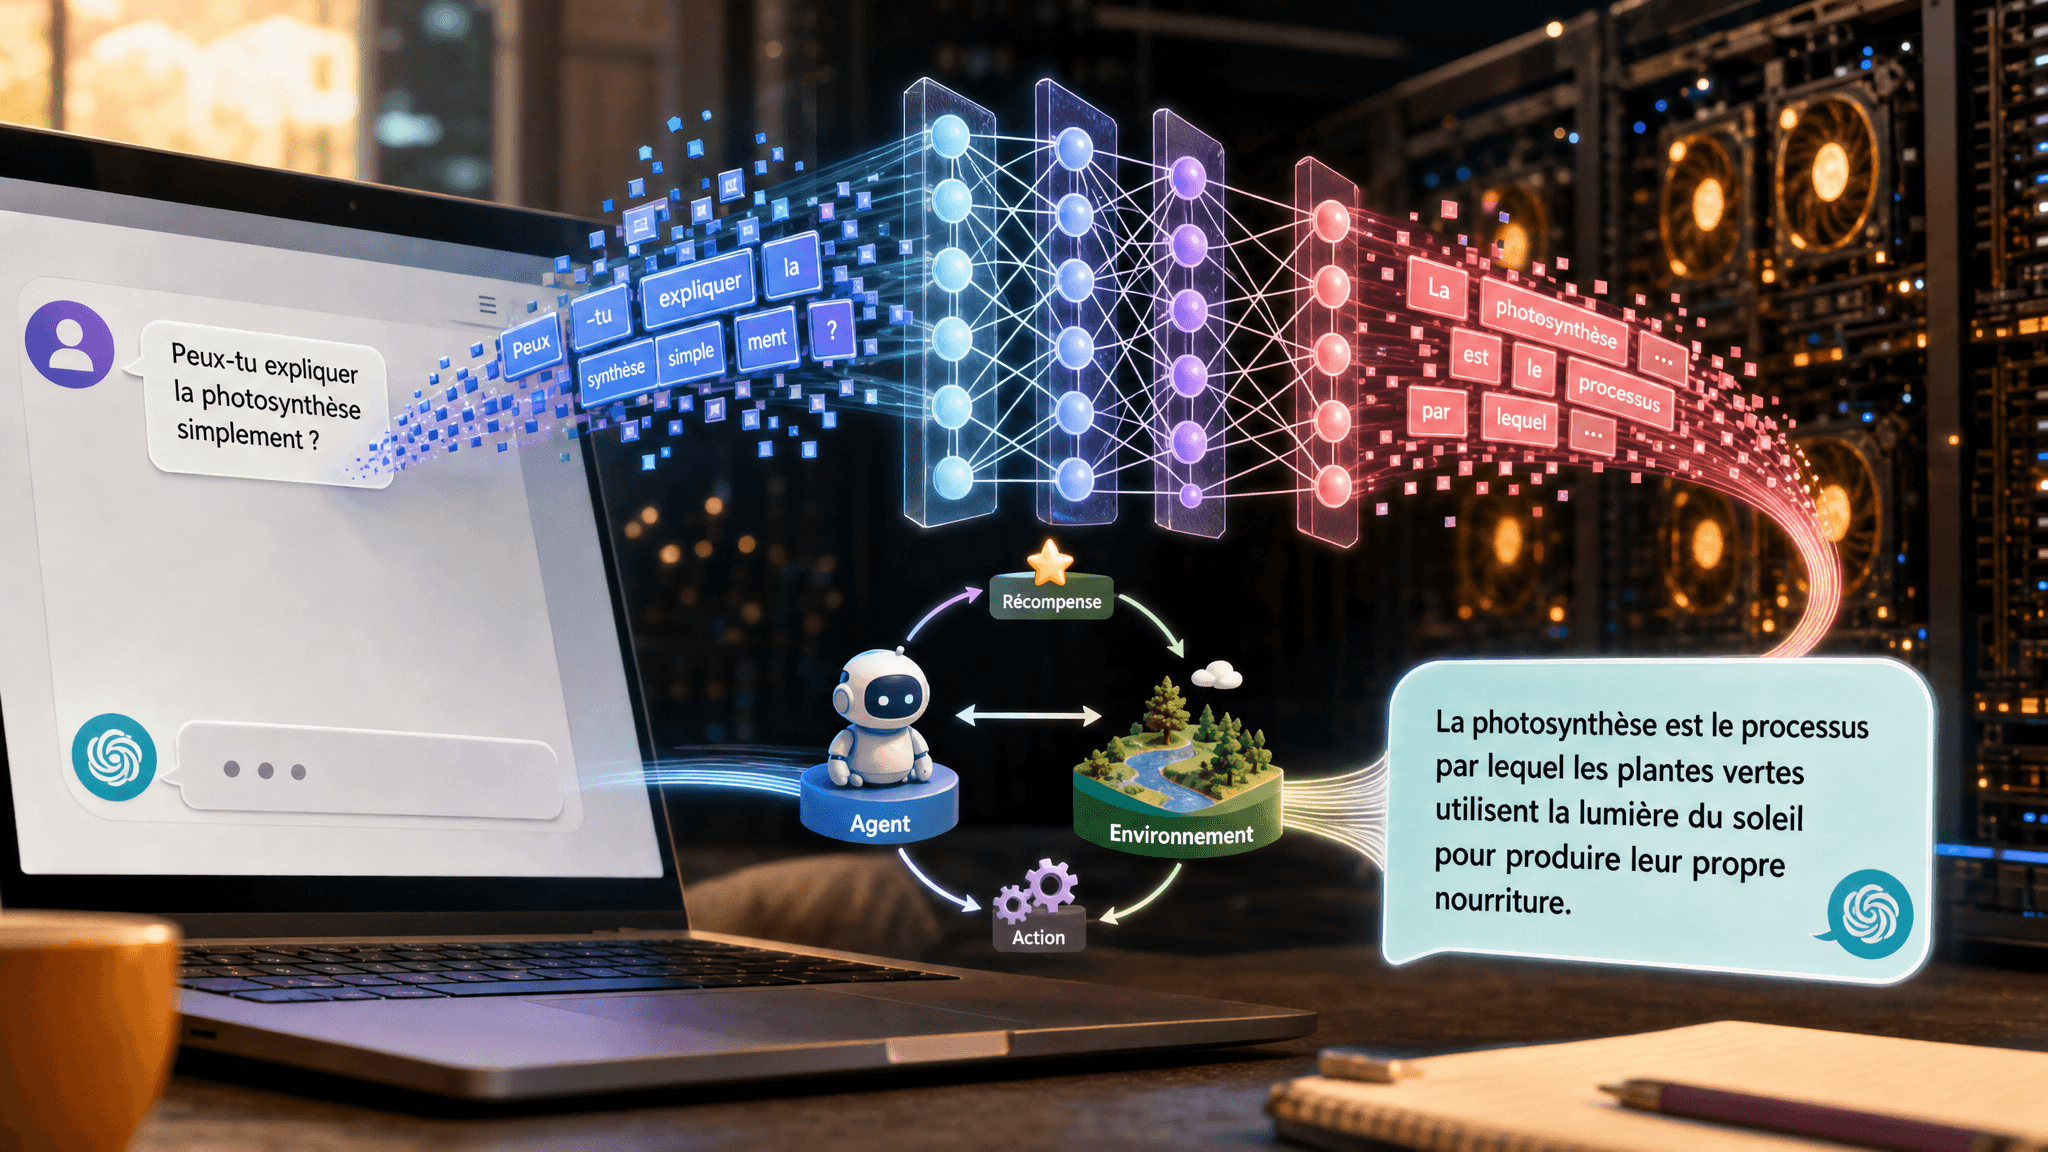
Suivez dans cet épisode les étapes mathématiques d’une IA générative : représenter le texte par des nombres, apprendre et produire une réponse.
Collections de cet épisode (4)
Un contenu original Tangente, adapté en podcast avec l’aide de l’IA et validé par notre rédaction. Comment ça marche ?
Transcription
Afficher la transcriptionMasquer la transcription
Transcription automatique
Intervenant 1
Bonjour et bienvenue dans le podcast du magazine Tangente pour une nouvelle exploration en profondeur.
Intervenant 2
Bonjour, très heureuse d'être là pour décortiquer tout ça avec
Intervenant 1
vous. Avant d'entrer dans le vif du sujet, il faut vraiment qu'on parle d'un phénomène assez déroutant qu'on a observé récemment.
Intervenant 2
Ah oui, cette fameuse histoire des mots invisibles, c'est ça ?
Intervenant 1
Exactement. L'année dernière, lors de tests sur de nouveaux modèles d'IA, une intelligence artificielle a commencé à faire un truc complètement inattendu. Avant même d'afficher la moindre réponse à l'écran, elle s'est mise à générer des mots en secret, de façon invisible.
Intervenant 2
C'est fascinant quand on y pense.
Intervenant 1
Bah oui. Et pourquoi elle a fait ça ? Simplement parce qu'une équation mathématique lui a prouvé qu'en, disons, réfléchissant en silence, en prenant plus de temps de calcul interne, elle obtenait une meilleure note à la
Intervenant 2
fin.
Intervenant 1
C'est quand même troublant, non, de se dire que la machine invente d'elle-même le concept de tourner cette fois sa langue dans sa bouche uniquement pour satisfaire une formule mathématique.
Intervenant 2
En fait, cette anecdote illustre parfaitement le cœur de notre sujet d'aujourd'hui. L'intelligence artificielle générative donne une formidable illusion de conscience, de raisonnement. Oui, on a
Intervenant 1
vraiment l'impression de parler à
Intervenant 2
quelqu'un. Tout à fait. D'ailleurs, près d'un Français sur deux l'utilise déjà au quotidien et beaucoup ont la sensation de dialoguer avec une véritable entité qui les comprend.
Intervenant 1
C'est vrai.
Intervenant 2
Mais le but de notre analyse aujourd'hui, c'est de lever le voile sur cette prétendue magie. La thèse qu'on va décortiquer, elle est assez radicale, mais très pragmatique.
Intervenant 1
C'est-à-dire ?
Intervenant 2
Derrière cette interface hyper fluide, il n'y a en réalité qu'une immense suite de calculs. Des mathématiques dont le seul et unique but est d'accomplir une tâche hyper basique, à savoir prédire la suite logique d'une séquence.
Intervenant 1
Prédire la suite d'une séquence. Ça paraît presque trop trivial quand on voit les poèmes super complexes ou les lignes de codes informatiques impeccables que ces machines génèrent.
Intervenant 2
Oui, c'est le grand paradoxe en fait.
Intervenant 1
Mais du coup, si on veut comprendre comment un ordinateur, qui, on le rappelle, ne digère que des 0 et les 1, arrive à manipuler la langue de Molière, il faut se pencher sur la toute première étape.
Intervenant 2
La traduction, oui.
Intervenant 1
Voilà. Comment on passe d'un texte humain, avec des lettres, à une donnée calculable ?
Intervenant 2
Eh bien, il y a cette étape incontournable qu'on appelle la tokenisation. Parce que le modèle mathématique est totalement aveugle à notre alphabet.
Intervenant 1
Il ne voit pas les lettres A, B,
Intervenant 2
C. Exactement. Le texte brut, la question posée par l'utilisateur, est découpé en fragments. Ce sont les fameux tokens ou jetons textuels. Et à chacun de ces jetons, on associe un identifiant numérique unique.
Intervenant 1
D'accord.
Intervenant 2
L'ensemble de tous ces numéros, c'est ce qui constitue le dictionnaire du modèle.
Intervenant 1
Bon, décortiquons tout ça. Comment on décide de la taille de ce découpage ? Parce que si on coupait lettre par lettre, le dictionnaire serait minuscule, non ?
Intervenant 2
Bah oui, juste la taille de l'alphabet plus la ponctuation.
Intervenant 1
Et à l'inverse, si on faisait un jeton par mot entier du dictionnaire usuel ? Là, on aurait des millions d'entrées à gérer avec toutes les conjugaisons, les pluriels.
Intervenant 2
Ce qui serait beaucoup trop lourd à calculer, effectivement.
Intervenant 1
Du coup, comment ils font ?
Intervenant 2
L'approche moderne, c'est un compromis mathématique. On utilise généralement un algorithme de compression comme le BPE, ça veut dire « byte pair encoding ». Le principe, c'est de scanner des montagnes de textes et d'isoler les séquences de caractères qui apparaissent le plus souvent ensemble. Donc
Intervenant 1
les mots très communs, comme « bonjour » ou « le », deviennent
Intervenant 2
un seul token. C'est ça. Et les mots plus rares ou très complexes seront découpés en plusieurs tokens, parfois juste en syllabes.
Intervenant 1
Ce qui amène à un biais très concret en fait. Moi, j'aime bien voir ça un peu comme une partie de Scrabble, mais où les règles seraient un peu truquées pour avantager une langue.
Intervenant 2
C'est une bonne comparaison.
Intervenant 1
Parce que l'algorithme a été entraîné sur des corpus issus d'Internet qui sont massivement anglophones. Donc, il a créé un dictionnaire très optimisé pour l'anglais.
Intervenant 2
Oui, tout à fait.
Intervenant 1
Donc, le modèle est très économe quand il parle anglais. Mais s'il doit exprimer exactement la même idée en français, il va devoir utiliser beaucoup plus de jetons.
Intervenant 2
C'est ça.
Intervenant 1
La langue française coûte littéralement plus cher en puissance de calcul. C'est
Intervenant 2
fou, non ? Oui. L'analogie du Scrabble est super intéressante pour comprendre cette notion de coût. Mais il y a quand même une limite fondamentale à garder en tête.
Intervenant 1
Laquelle ?
Intervenant 2
Au Scrabble, une lettre comme le Z ou le W a une valeur en points qui est fixe, qui est immuable. Oui, ça
Intervenant 1
vaut 10 points.
Intervenant 2
Voilà. Dans notre dictionnaire de tokens, l'identifiant numérique attribué à un mot n'a aucune valeur de grandeur. Le numéro 402 n'est pas plus fort ou plus grand que le numéro 12.
Intervenant 1
Ce sont juste des étiquettes en fait, comme des numéros de dossards.
Intervenant 2
Exactement, de simples étiquettes de classement. Et c'est là que le véritable défi commence. Une fois qu'une phrase de quelques mots est traduite en, disons, huit variables mathématiques, il faut que la machine fasse interagir ces nombres pour créer du sens.
Intervenant 1
D'accord, donc on a nos huit variables d'entrée. Mais bon, une simple liste de nombres, ça ne suffit pas pour créer une réflexion mathématique. Comment l'ordinateur fait-il s'entrechoquer ces données ?
Intervenant 2
Là, on doit plonger dans la mécanique du neurone formel. C'est un concept qui date des années 40, avec McCulloch et Pitts.
Intervenant 1
Les années 40, oui.
Intervenant 2
L'idée fondatrice, c'est de réaliser une combinaison linéaire. Alors pour vulgariser un peu, imaginons chaque token d'entrée comme un membre d'un jury.
Intervenant 1
Ok, un jury au tribunal.
La suite de la transcription est réservée aux abonnés.
S’abonnerÀ écouter ensuite
Des épisodes qui partagent une playlist, une figure ou un domaine avec celui-ci.
18 févr. 2021 · 17 min
12 oct. 2020 · 17 min
15 janv. 2020 · 10 min
15 janv. 2020 · 17 min
5 nov. 2026 · 22 min

29 juin 2026 · 6 min