5 nov. 2026 · 22 min
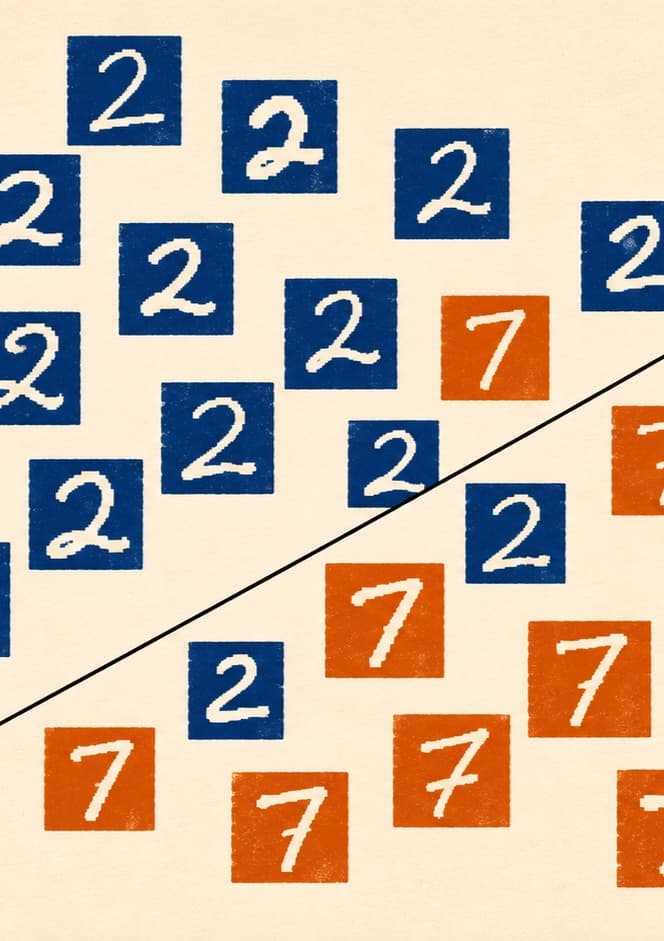
Apprentissage statistique : comment distinguer un 2 d’un 7 ?
Suivez dans ce podcast la construction d’un modèle d’apprentissage statistique pour distinguer deux chiffres manuscrits, des exemples d’entraînement au test.
Collections de cet épisode (4)
Un contenu original Tangente, adapté en podcast avec l’aide de l’IA et validé par notre rédaction. Comment ça marche ?
Transcription
Afficher la transcriptionMasquer la transcription
Transcription automatique
Intervenant 1
Bienvenue dans le podcast du magazine Tangente. Bonjour à toutes et à tous. Je suis vraiment ravie de vous retrouver pour une nouvelle plongée au cœur d'un sujet qui nous concerne tous.
Intervenant 2
Bonjour tout le monde. Aujourd'hui, on s'attaque à un gros morceau.
Intervenant 1
Un très gros morceau, oui. Notre exploration du jour s'appuie sur des travaux de recherche fascinants issus de Matadata. Et notre mission, c'est tout simplement de démystifier l'intelligence artificielle.
Intervenant 2
Rien que
Intervenant 1
ça ? Rien que ça, oui. Mais on va le faire sans tomber dans les clichés de science-fiction avec les robots qui prennent le pouvoir et tout le tralala. On va vraiment regarder sous le capot pour comprendre son moteur fondamental, à savoir l'apprentissage statistique.
Intervenant 2
C'est ça, le cœur du réacteur en fait. Ce qui est génial avec l'approche de nos sources, c'est qu'on revient à une réalité très concrète, très pragmatique. On va voir comment des algorithmes arrivent à transformer notre réalité physique, comme de simples images, en équations mathématiques.
Intervenant 1
Et tout ça pour pouvoir prendre des décisions. C'est fou quand on y pense. Et pour rendre ça super clair, on va décortiquer un exemple qui a l'air bête comme chou au premier rapport. Apprendre à une machine à faire la différence entre un chiffre 2 et un chiffre 7 écrit à la
Intervenant 2
main. Ça paraît hyper élémentaire. Pour nous, distinguer un 2 d'un 7, c'est automatique. Notre cerveau le fait sans aucun effort conscient. Mais pour une machine, c'est un véritable mur conceptuel. Et en fait, cet exemple contient absolument toute la complexité du problème. Avant même de parler de réseaux de neurones complexes, il faut se poser une question de base. C'est quoi « apprendre » pour un morceau de silicium et du code informatique ?
Intervenant 1
Bah oui, parce qu'un ordinateur, ça n'a pas de conscience. Alors, que signifie ce mot « apprendre » dans ce contexte ?
Intervenant 2
La définition de l'apprentissage statistique que donnent les chercheurs, elle est d'une clarté redoutable. En gros, apprendre pour une machine, c'est estimer une réponse à partir de données numériques en faisant le moins d'erreurs possible.
Intervenant 1
D'accord. Donc on cherche juste à minimiser
Intervenant 2
l'erreur. Exactement. Toute la philosophie du domaine est là-dedans. C'est très différent de la programmation classique. En programmation classique, on donnerait à la machine une liste de règles super strictes. Du genre, si tu vois une boucle en bas et une grande diagonale, alors c'est un 2.
Intervenant 1
Ouais, on écrirait chaque étape à la main quoi.
Intervenant 2
Voilà. Mais là, non. En apprentissage statistique, on fournit à la machine un algorithme vierge. Un truc vide, mais avec des paramètres qu'on peut ajuster. Et ensuite on le nourrit avec des données.
Intervenant 1
Donc la machine doit trouver ses propres règles par la force de l'entraînement. Si on essaie de visualiser un peu le truc, ça me fait penser aux révisions d'un étudiant avant un gros examen.
Intervenant 2
C'est une super analogie, ouais.
Intervenant 1
Imaginons cet étudiant. Il a devant lui un gros manuel avec, disons, des milliers de problèmes de maths. Et la clé, c'est qu'il a les corrigés à la fin du livre.
Intervenant 2
Oui, très
Intervenant 1
important les corrigés. Ah oui. Donc, il essaie de résoudre un problème. Ensuite, il va voir la solution. Il constate qu'il s'est planté et du coup, il ajuste sa méthode de réflexion et il recommence inlassablement jusqu'à ce que son taux d'erreur sur ce manuel précis s'approche de zéro.
Intervenant 2
C'est vraiment la métaphore parfaite pour comprendre les deux phases indissociables de l'apprentissage. La première phase, c'est la phase d'entraînement. C'est exactement ton étudiant avec son manuel.
Intervenant 1
Donc on lui donne plein d'exemples
Intervenant 2
connus. C'est ça. Techniquement, on fournit à l'algorithme une base de données énorme, genre des dizaines de milliers d'images de chiffres, et on lui donne la bonne réponse à chaque fois. On lui dit ça, c'est un 2. Ça, c'est un 7.
Intervenant 1
D'accord.
Intervenant 2
Le but de l'algorithme, ça va être de modifier ses rouages internes pour que la réponse qu'il sort finisse par correspondre à la réponse qu'on attend de lui. Il cherche à minimiser son erreur moyenne sur toute la base d'entraînement.
Intervenant 1
Mais le piège avec l'étudiant, ce serait qu'il finisse par apprendre les corrigés de son livre par cœur. S'il fait ça, au lieu de comprendre la vraie logique des maths, il aura tout bon pendant ses révisions, c'est sûr.
Intervenant 2
Absolument. Il aura 20 sur 20 à l'entraînement.
Intervenant 1
Voilà. Mais le jour de l'examen final, quand le prof va lui donner des problèmes qu'il n'a jamais vus de sa vie, la catastrophe, il va s'effondrer.
Intervenant 2
Pour une intelligence artificielle, c'est pareil. C'est pour ça qu'il y a la deuxième phase, la phase de test. Elle est vraiment cruciale. Une fois que la machine a fini de s'entraîner, on verrouille tous ses paramètres. On ne touche plus à rien.
Intervenant 1
Fini les révisions.
Intervenant 2
Exactement. Et là, on lui présente de nouvelles données, de nouvelles images de chiffres qu'elle n'a absolument jamais vues pendant son entraînement. C'est l'examen final.
Intervenant 1
Et c'est là qu'on voit si elle a vraiment appris quelque
Intervenant 2
chose. C'est uniquement le taux d'erreur sur ce test-là, ce test indépendant, qui permet de valider le système. C'est ça qui nous dit si l'algorithme a vraiment appris à reconnaître les formes d'un 2 ou d'un 7, ou s'il s'est juste contenté de mémoriser bêtement la base d'entraînement par cœur.
Intervenant 1
Donc le but ultime, c'est vraiment la généralisation.
Intervenant 2
C'est le mot-clé. La capacité de généralisation.
Intervenant 1
C'est super clair en théorie, mais il y a un truc très terre à terre qui me chiffonne. Un ordinateur, ça n'a pas d'yeux, ça n'a pas de rétine ni de cortex visuel.
Intervenant 2
Non, en effet.
Intervenant 1
Du coup, quand on lui présente un chiffre griffonné sur un bout de papier, il ne peut pas percevoir les courbes, l'épaisseur de l'encre, le contraste. Comment la machine fait-elle pour voir cette réalité physique au départ ?
Intervenant 2
C'est là que la magie de la numérisation opère. Pour passer du papier au monde des stats, il faut faire une traduction. Pour un ordinateur, une image, ce n'est pas une image. C'est juste un immense tableur. Une grille. Une grille de
Intervenant 1
nombres, tu veux dire ?
La suite de la transcription est réservée aux abonnés.
S’abonnerÀ écouter ensuite
Des épisodes qui partagent une playlist, une figure ou un domaine avec celui-ci.
25 août 2020 · 14 min
5 nov. 2026 · 15 min
25 août 2020 · 16 min
24 août 2020 · 24 min
15 janv. 2020 · 22 min
16 janv. 2017 · 23 min