5 avr. 2017 · 13 min
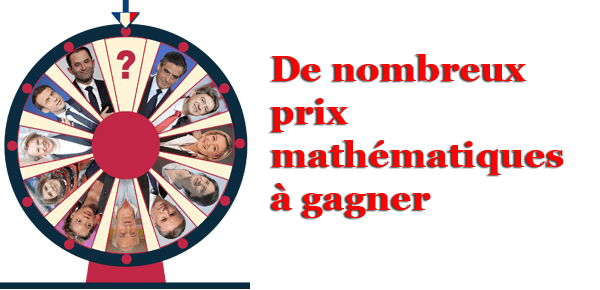
Pronostics présidentiels : pourquoi le plus petit écart gagnait-il ?
Suivez les deux étapes du concours de 2017, des scores pronostiqués au calcul des écarts qui départageait les joueurs après chaque tour.
Collections de cet épisode (1)
Un contenu original Tangente, adapté en podcast avec l’aide de l’IA et validé par notre rédaction. Comment ça marche ?
Transcription
Afficher la transcriptionMasquer la transcription
Transcription automatique
Intervenant 1
Bienvenue dans le podcast du magazine Tangente. Je suis vraiment ravie d'accueillir le public aujourd'hui pour notre nouvelle analyse.
Intervenant 2
Bonjour à tous. Très heureux d'être là pour cette discussion.
Intervenant 1
Alors d'habitude, prédire l'issue d'une élection présidentielle, c'est souvent écouter les sondages à la télé ou débattre avec passion. C'est très émotionnel, très viscéral.
Intervenant 2
C'est vrai, c'est même presque toujours politisé à l'extrême.
Intervenant 1
Exactement. Mais, et c'est là que ça devient intéressant, que se passerait-il si on retirait toute l'émotion de l'équation ? Si on exigeait, disons, une prédiction parfaite, et ce, à la deuxième décimale près.
Intervenant 2
Avec des sanctions mathématiques impitoyables en cas d'erreur, j'imagine.
Intervenant 1
Ah oui, impitoyable ! C'est en fait la prémisse d'un défi intellectuel assez génial que la rédaction du magazine a mis en place pour cette période électorale. C'est un grand concours de pronostics, totalement gratuit d'ailleurs, qui est adossé à un dossier spécial sur les paris.
Intervenant 2
Et c'est un dispositif qui se démarque tout de suite. En fait, c'est pas du tout un tirage au sort ou un jeu de hasard où on coche des cases au pif.
Intervenant 1
Pas du tout, non.
Intervenant 2
L'architecture du truc, elle repose sur une vraie modélisation statistique, une précision redoutable. Là, on entre vraiment de plein pied dans la science des données.
Intervenant 1
Et c'est justement la mission de notre exploration d'aujourd'hui, soulever un peu le capot de cette machinerie, parce que derrière l'aspect un peu ludique, il y a des concepts algorithmiques
Intervenant 2
fascinants. Absolument. Les concepteurs ont imposé une rigueur implacable.
Intervenant 1
Pour bien comprendre l'ampleur de la tâche, il faut se pencher sur la toute première étape. Le concours s'ouvre sur le site du magazine entre le 7 et le 21 avril. Et la consigne, elle a l'air simple, il faut parier sur les pourcentages de 4 ou 5 candidats au premier tour.
Intervenant 2
Mais la difficulté saute aux yeux quand on lit le règlement. Il y a cette obligation de fournir un chiffre avec deux décimales.
Intervenant 1
Ouais, deux décimales.
Intervenant 2
On ne demande pas une estimation à la louche, c'est un pronostic au centième de pour cent près.
Intervenant 1
Et franchement, ça soulève une vraie question. Parce que quand on regarde les sondages officiels, ceux des professionnels, on nous parle toujours de marge d'erreur de 1, 2 ou même 3 points. Tout à fait. Les instituts arrondissent souvent à l'entier ou au demi-point. Donc exiger deux décimales, c'est pas demander un niveau de certitude que même la science refuse
Intervenant 2
d'afficher. Vu de l'extérieur, oui, ça paraît presque absurde. Mais en fait, cette contrainte des deux décimales, elle répond à une nécessité purement structurelle pour le jeu.
Intervenant 1
Ah bon ? Comment
Intervenant 2
ça ? Imaginez un concours national qui attire des milliers de personnes, souvent très douées avec les chiffres. Le risque d'excès éco est juste monumental.
Intervenant 1
Ah oui, c'est vrai.
Intervenant 2
Si on se limitait à des nombres entiers, on aurait mathématiquement des centaines de participants avec exactement le même score. Ce serait intenable pour les départager.
Intervenant 1
D'accord, je vois.
Intervenant 2
Donc ces centièmes de pour cent, ils agissent un peu comme un scalpel. Ça crée la variance nécessaire pour vraiment faire ressortir les meilleurs modèles.
Intervenant 1
Donc c'est pour séparer les joueurs. Mais le vrai piège, enfin, ce qui m'a le plus marqué, c'est la méthode de notation. Ah,
Intervenant 2
le fameux calcul des points.
Intervenant 1
Voilà. Le règlement dit que quand les vrais résultats tomberont, le score du joueur sera calculé selon, je cite, « la somme des valeurs absolues des différences entre le pari et le score réel ».
Intervenant 2
Et c'est là que tout bascule. Cette notion de valeur absolue, elle modifie complètement la philosophie de l'exercice.
Intervenant 1
En quoi exactement ? Pour ceux qui auraient un peu oublié leur cours de maths.
Intervenant 2
En gros, appliquer la valeur absolue à un nombre, ça revient à lui enlever son signe. Qu'il soit positif ou négatif, on s'en fiche. On ne garde que son ampleur, cette distance par rapport au zéro.
Intervenant 1
L'image qui me vient en tête, c'est comme un jeu de fléchettes, mais avec des règles hyper strictes.
Intervenant 2
C'est une très bonne analogie, oui.
Intervenant 1
En fait, si on lance la fléchette et qu'on rate le centre, on ne regarde pas si on a tiré 3 à gauche ou 3 à droite. Ça n'a aucune importance. On prend juste un mètre ruban entre le centre et l'impact et on mesure la distance.
Intervenant 2
C'est exactement ça. Et la pénalité, c'est 7 distances pures.
Intervenant 1
Donc si on comprend bien, le but du jeu c'est pas de marquer des points.
Intervenant 2
Surtout pas non. Le but c'est d'en avoir le moins possible. Chaque point est une pénalité. Et le choix de la valeur absolue s'est fait exprès pour bloquer une faille classique en analyse de données.
Intervenant 1
Laquelle ?
Intervenant 2
Le phénomène de compensation. Sans la valeur absolue, on pourrait avoir un participant avec des pronostics complètement faux mais qui obtiendrait un score parfait.
Intervenant 1
Attendez, comment ça serait possible ?
Intervenant 2
Bah, imaginez, il surestime le premier candidat de 3 points. Et il sous-estime un deuxième candidat de 3 points aussi. S'il n'y avait pas de valeur absolue, on ferait l'addition. Plus 3 à moins 3, ça fait 0. Oh
Intervenant 1
la vache, oui. Il aurait l'air d'avoir un modèle parfait alors qu'il s'est planté sur les deux.
Intervenant 2
Voilà, alors qu'avec la valeur absolue, le plus 3 devient 3 points de pénalité, le moins 3 devient aussi 3 points de pénalité. Bam, le joueur se retrouve avec 6 points de pénalité.
Intervenant 1
L'addition est cruelle.
Intervenant 2
Très cruelle. C'est une course effrénée pour garder son compteur proche de zéro. Et chaque décimal compte.
Intervenant 1
Et ce fardeau, il va peser lourd. Parce que cette première phase, en fait, c'est juste un processus de sélection. Il y a un coup près qui tombe pour passer à la deuxième étape.
Intervenant 2
Oui, le premier tour est un filtre et il ne pardonne pas.
Intervenant 1
C'est ça. Le règlement précise que pour accéder à l'étape 2, qui se tient du 25 avril au 5 mai, il faut impérativement avoir parié sur la bonne affiche finale. Ceux qui n'ont pas les deux bons finalistes sont éliminés d'office.
Intervenant 2
En mathématiques, c'est ce qu'on appelle une condition nécessaire mais non suffisante.
Intervenant 1
C'est-à-dire ?
Intervenant 2
C'est-à-dire que vous avez pu faire un modèle d'une précision chirurgicale sur les petits candidats, avoir très peu de pénalités sur eux. Mais si, à cause du bruit statistique, vous avez inversé le deuxième et le troisième candidat ?
Intervenant 1
Tout le reste ne sert plus à rien.
Intervenant 2
Exactement. La précision globale est balayée. Ce filtre qualitatif exige que le scénario principal soit correct.
Intervenant 1
C'est imbitoyable. Et même pour ceux qui passent ce filtre, le jeu mute complètement pour le second tour. Les règles changent.
Intervenant 2
Ah la finale. Oui, la dynamique n'a plus rien à voir.
Intervenant 1
Il faut encore pronostiquer le score des finalistes à deux décimales près. Sauf que là, il y a un coefficient multiplicateur. Les points de pénalité de ce duel sont doublés, avant d'être ajoutés aux pénalités du premier tour.
Intervenant 2
Et ce petit détail, le fait de doubler, ça redessine tout le profil de risque du concours.
Intervenant 1
Mais du coup, une petite question, ça veut pas dire qu'un participant qui a eu un score juste moyen au premier tour peut complètement écraser quelqu'un de brillant, juste en réussissant ce dernier calcul ?
Intervenant 2
Si, totalement. L'architecture du jeu donne un poids absolument écrasant à la finale. Au premier tour, l'erreur était diluée sur quatre ou cinq variables. Là, le système se resserre sur deux variables et la sanction est gonflée artificiellement.
Intervenant 1
Et dans un duel, il y a ce qu'on appelle un effet de vase communiquant, non ?
Intervenant 2
Le fameux jeu à somme nulle, oui. Si on enlève le vote blanc, la somme des pourcentages fait 100. Si un candidat gagne 1%, l'autre le perd.
Intervenant 1
Et avec le multiplicateur, ça doit créer une explosion des pénalités.
Intervenant 2
Une véritable explosion, ouais. Prenons un cas d'école très simple. Vous pariez sur un résultat de 52 contre 48.
Intervenant 1
Ok.
Intervenant 2
Mais le vrai résultat, c'est 53 contre 47.
Intervenant 1
Donc juste un point d'écart, c'est une super bonne prédiction en soi.
Intervenant 2
Dans la vraie vie, oui. Mais regardez le calcul. L'erreur de 1 point sur le gagnant donne 1 point de pénalité. Multiplié par 2, ça fait 2 points.
Intervenant 1
D'accord.
Intervenant 2
Et symétriquement, l'erreur d'1 point sur le perdant, multiplié par 2, ça fait encore 2 points.
Intervenant 1
Oh là là, donc pour un décalage de seulement 1%, on encaisse 4 points de pénalité d'un coup ?
Intervenant 2
Voilà. Un bloc massif de 4 points qui vient complètement plomber le travail de dentelle fait au premier tour. La marge d'erreur devient quasi-inexistante.
Intervenant 1
Donc se contenter de lire les sondages à ce stade, c'est un peu suicidaire mathématiquement parlant.
Intervenant 2
Totalement. C'est là qu'on réalise que ce n'est pas un simple concours. C'est un vrai exercice de data science.
Intervenant 1
Et heureusement, le règlement a prévu une clause géniale pour ça. On peut modifier et affiner ces chiffres en continu jusqu'à la dernière seconde avant la clôture.
Intervenant 2
Et c'est fondamental. La donnée sociale, c'est pas figé, c'est organique. Ça bouge avec les événements de campagne. Offrir cette flexibilité, ça encourage une démarche d'itération.
Intervenant 1
C'est ce qu'on appelle l'inférence bayésienne, c'est
Intervenant 2
ça ? Exactement. En statistique, l'idée bayésienne, c'est de ne jamais voir une probabilité comme définitive. On a une estimation de départ, la probabilité a priori, et on la met à jour dès qu'on a de nouvelles données.
Intervenant 1
Donc, le pronostic évolue et s'affine au fil des jours.
Intervenant 2
C'est ça. On réduit l'incertitude petit à petit.
Intervenant 1
Mais pour aider les participants à faire ça, Tangente ne les laisse pas tout seuls. Il y a des liens vers les agrégateurs de sondage, bien sûr. Mais surtout, et c'est la pièce maîtresse, il y a des liens vers des études scientifiques.
Intervenant 2
Ah oui, c'est ça qui change la donne.
Intervenant 1
Des travaux universitaires qui décortiquent historiquement les écarts entre les intentions de vote déclarées et les vrais résultats dans les urnes.
Intervenant 2
Et intégrer cette littérature, ça pousse l'exercice à son paroxysme. Parce que les instituts de sondage y travaillent bien, mais ils ont des failles, des biais structurels liés à la nature humaine.
Intervenant 1
Le fameux phénomène de désirabilité sociale dont on parle souvent en sociologie.
Intervenant 2
Oui, ce paradoxe humain. Quand on pose une question à quelqu'un, il ne dit pas toujours la vérité.
Intervenant 1
Bah oui, il y a une partie des gens qui vont cacher leur vote si leur candidat est très stigmatisé. Ils vont donner une réponse plus, disons, acceptable socialement.
Intervenant 2
Le fameux vote caché. Et à l'inverse, il y a des effets de surdéclaration pour des candidats perçus comme gagnants ou moralement valorisants, même si ça ne se traduit pas toujours dans l'isoloir.
Intervenant 1
Et donc, en lisant ces études, les participants peuvent appliquer une technique clé, le redressement statistique.
Intervenant 2
Voilà, on ne prend plus le sondage comme la vérité absolue, on prend la donnée brute, on applique un modèle d'erreur historique et on calcule une correction.
Intervenant 1
Donc si je comprends bien, prenons un exemple. Je vois un candidat à 24% dans les sondages la veille de la clôture. Si je m'arrête là, je tape 24 et j'attends.
Intervenant 2
C'est ça.
Intervenant 1
Mais si je creuse les études, je peux découvrir que ce courant politique, par exemple, subit un vote caché systémique d'environ 1,5 point.
Intervenant 2
Exactement. Et là, votre travail d'ajustement commence. Vous n'allez pas parier 24. Vous prenez le chiffre, vous ajoutez la correction historique, vous modélisez la dynamique des derniers jours.
Intervenant 1
Et je finis par parier, je sais pas, 25,65%. Et ce
Intervenant 2
faisant, vous corrigez publiquement l'erreur du sondage.
Intervenant 1
C'est fascinant parce que la subtilité, c'est de faire le tri. Le bruit médiatique, les petites variations quotidiennes, c'est le bruit statistique.
Intervenant 2
Ouais.
Intervenant 1
Mais l'ancrage profond, la vraie tendance, c'est le signal. Et le concours demande de créer un filtre pour annuler ce bruit et isoler le signal.
Intervenant 2
Qui est l'un des défis les plus difficiles des statistiques d'aujourd'hui. Le magazine transforme ses lecteurs en véritables analystes de données.
Intervenant 1
Et un tel effort mental, il mérite une récompense matérielle. Tangente n'a pas fait les choses à moitié.
Intervenant 2
J'imagine que la dotation est intéressante.
Intervenant 1
Ah oui, une enveloppe globale de 5000 euros a été prévue. Distribué sous forme de bon d'achat pour des ouvrages et magazines de culture mathématique, partagé entre tous les qualifiés de la deuxième
Intervenant 2
étape.
Intervenant 1
Et le Graal, le premier prix pour la personne qui aura le plus petit nombre de points de pénalité sur les deux tours, c'est un bon d'achat individuel de 250 euros, valable sur les produits POLE.
Intervenant 2
Gagner un concours en cherchant à avoir le score le plus bas possible, c'est élégant analytiquement.
Intervenant 1
Et en prenant un peu de recul, on voit que cette initiative a une super portée éducative. Ça casse cette image des mathématiques comme un truc aride, coincé sur un tableau noir.
Intervenant 2
C'est clair. Ça montre que la modélisation et la rigueur, ce sont des lunettes incroyables pour lire notre monde, pour déchiffrer l'actualité avec froideur, sans se laisser emporter.
Intervenant 1
C'est un vrai rempart contre les biais cognitifs. Et d'ailleurs, ça m'amène à une dernière réflexion, un peu vertigineuse pour clore notre analyse.
Intervenant 2
Je vous
Intervenant 1
écoute. Imaginez, on va avoir des milliers de cerveaux passionnés de chiffres qui vont analyser des études, appliquer des redressements bayésiens, ajuster des décimales à la dernière minute.
Intervenant 2
Oui, une vraie ruche algorithmique.
Intervenant 1
Exactement. La puissance de calcul de tout ce réseau dépasse largement un institut isolé.
Intervenant 2
C'est indéniable d'en venir.
Intervenant 1
Cette méta-prédiction, cette fusion de milliers d'intelligences, est-ce qu'elle ne finirait pas par exploser n'importe quel sondage officiel en termes de précision ?
Intervenant 2
C'est la théorie de la sagesse des foules, illustrée à la perfection.
Intervenant 1
C'est ça. Si une collectivité est bien utile et statistiquement, elle finit par avoir raison face à l'incertitude. C'est une pensée fascinante à garder en tête pour observer la mécanique électorale.
Intervenant 2
Une très belle expérience grandeur nature en perspective en effet.
Intervenant 1
Absolument. Merci d'avoir suivi notre exploration aujourd'hui et de nous avoir accompagnés dans cette plongée au cœur de la science des données.
À écouter ensuite
Des épisodes qui partagent une playlist, une figure ou un domaine avec celui-ci.
10 juil. 2026 · 19 min
10 juil. 2026 · 25 min
9 juil. 2026 · 5 min

29 juin 2026 · 6 min
29 juin 2026 · 5 min

25 juin 2026 · 4 min